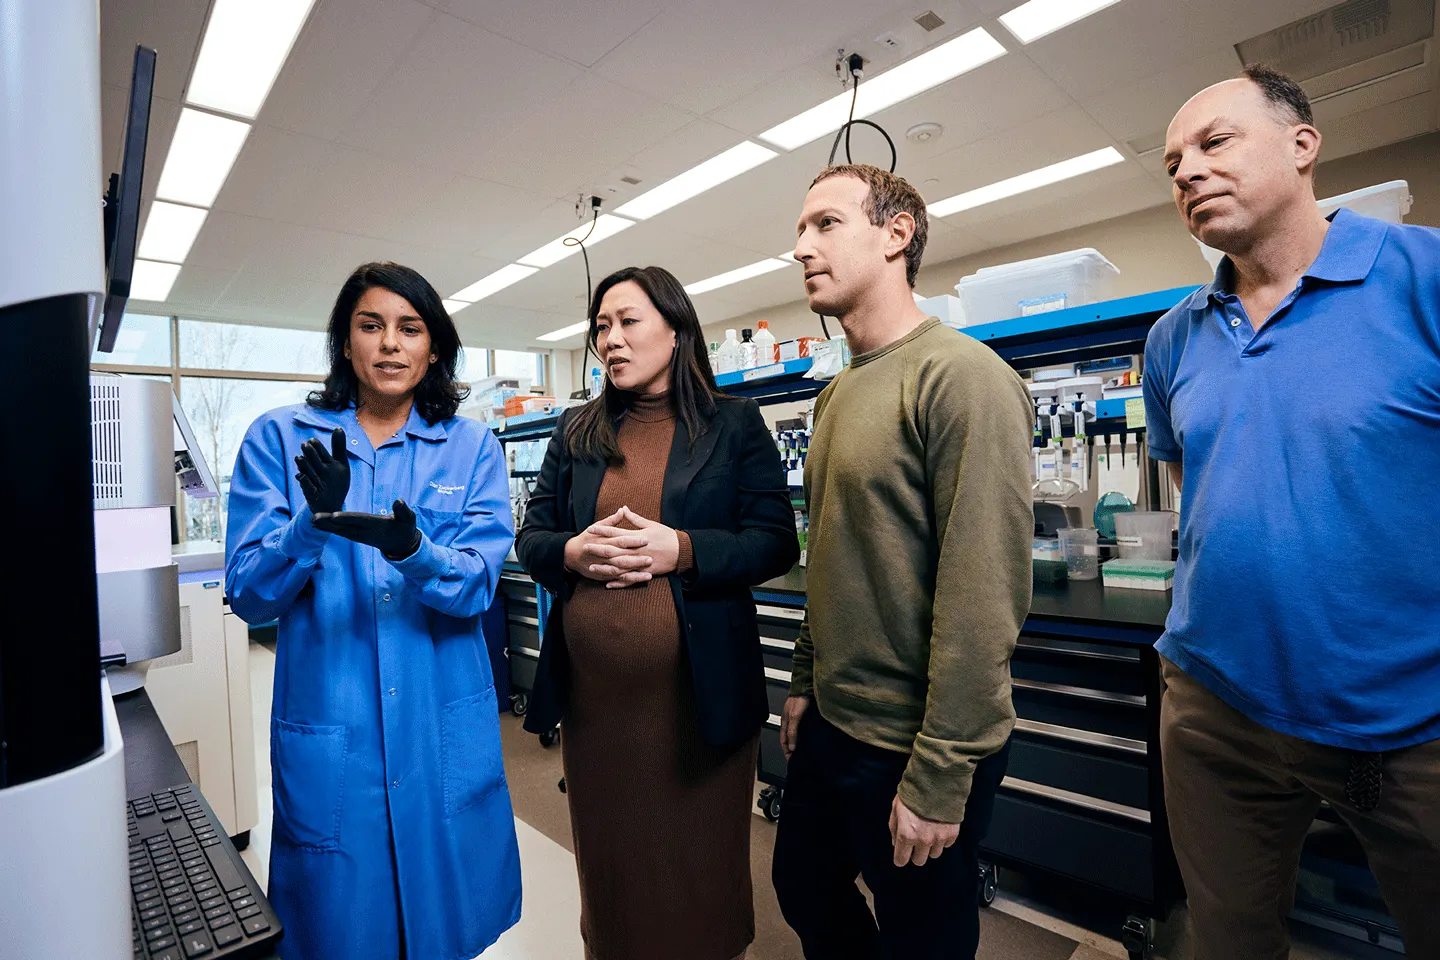
据Tengri Life 10月7日援引Axios报道,马克·扎克伯格和他的妻子普莉希拉·陈通过他们的科学慈善机构“陈·扎克伯格生物中心”(Chan Zuckerberg Biohub)发起了一项大型项目,旨在创建一个“通用虚拟细胞”。谷歌DeepMind、Isomorphic Labs、Meta以及美国政府机构都参与了这项计划。
这不是要创造一个物理细胞,而是基于人工智能开发一个数字副本。
该项目的主要目标是创建有史以来规模最大的标准化生物数据数据库,其中包括单细胞基因组学数据。计划将数十亿,最终数万亿个细胞进行数字化处理,用于训练人工智能模型。
由此产生的“虚拟细胞”旨在作为预测模型。它将使科学家能够在数字环境(即计算机模拟)中开展复杂的生物学实验。这将使他们能够在几秒钟内评估细胞对新药、基因改造或病毒的反应。
该计划设想收集并整合大量的生物数据,以创建一个“通用虚拟细胞”。第一阶段的目标是绘制细胞生物学和细胞对各种变化的反应的总体图谱。
该项目的商业合作伙伴将获得为期一年的独家数据使用权。之后,计划将数据公开。
Biohub 的科学主管 Alex Reeves 告诉 Axios,在实验室问题中加入更多逻辑分析和智慧将显著提高所获得的经验结果的价值。
里夫斯表示,人工智能目前已经能够处理蛋白质和生物结构。然而,要对整个活细胞进行建模,需要的数据量级要大得多,而这些数据必须在现实世界中获取。
“我们正处于人工智能领域新科学范式的开端,”里夫斯说。
他指出,生物学需要“经验人工智能”——即基于生物数据训练的模型,能够准确预测物理世界中发生的过程。
在收到第一个大规模数据集后的一年内,开发人员计划训练模型,评估其质量,并确定哪些类型的生物数据可以提高预测的准确性。
“它在各个领域都取得了成功,在生物学领域也取得了成功,”里夫斯说道,他指的是人工智能在蛋白质生物学领域的成功。
这些模型有望用于识别个体患者疾病的分子病因,并选择最佳干预措施。此外,该项目还有助于推进衰老和再生领域的研究。