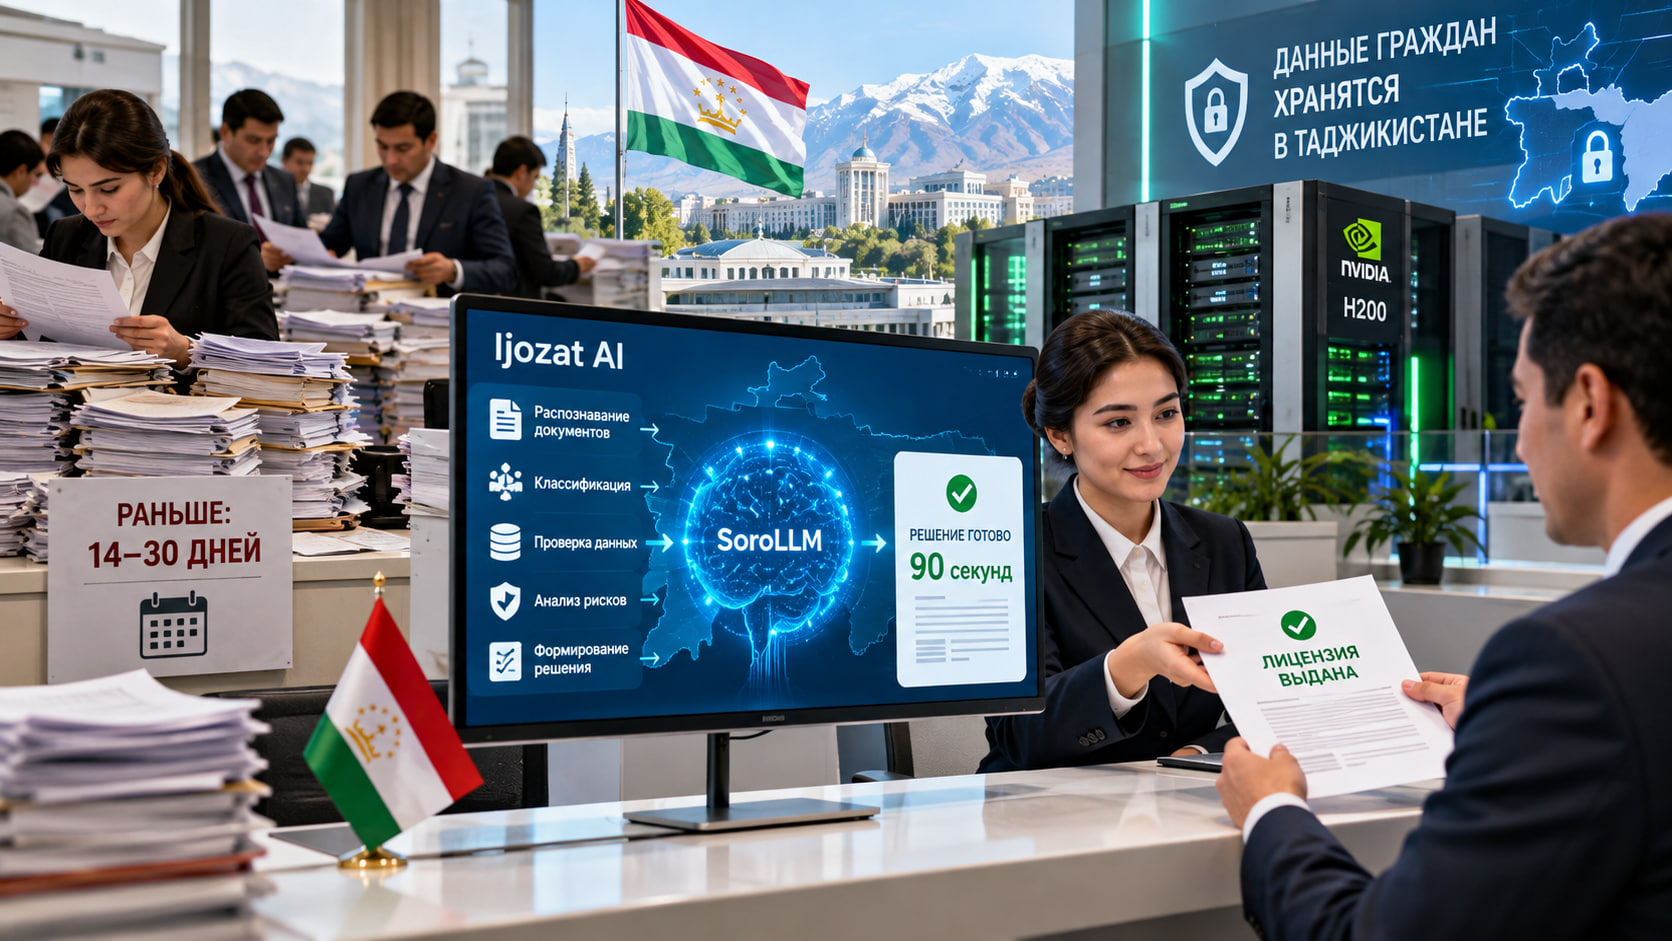
塔吉克斯坦正在实施一套基于人工智能的新型许可证系统,该系统将把申请处理时间从14至30天缩短至约90秒。该技术平台采用美国公司英伟达(NVIDIA)的基础设施构建,确保公民的个人数据完全存储在塔吉克斯坦境内。 英伟达在10月29日发布的关于塔吉克斯坦公共服务数字化的报告中披露了这一消息。
该项目旨在实现政府服务体系的现代化,为企业家和公民提供更优质的服务。传统的纸质文件流程将被一个安全可靠的数字平台所取代,该平台能够自动处理文件、核实信息,并就许可证和执照的发放生成意见。
为了实施该项目,塔吉克斯坦政府组建了一个由三家科技公司组成的合作生态系统:darya.ai、zehnlab.ai 和 Epsilon3.ai。每家公司负责系统工作的特定领域。
Darya.ai 提供计算能力,zehnlab.ai 开发了塔吉克斯坦第一个国家级大规模语言模型,Epsilon3.ai 创建了一个使用人工智能进行自动许可的应用程序。
从纸质文件到数字系统
此前,塔吉克斯坦负责颁发商业活动许可证和执照的政府机构主要使用纸质文件和扫描的 PDF 文件。
员工必须手动从收到的文件中提取必要的信息,然后将其与几个彼此不连接的信息系统进行核对。
因此,处理一份申请需要14到30天。一位合格的专家处理每份申请最多需要花费60分钟。
高峰期,申请积压增加,导致企业运营出现更多延误。
另一个挑战是收到的文件有塔吉克语、俄语和英语三种语言版本。过时的信息系统无法完整处理多语言材料。
此外,现有的基础设施缺乏连接新的数字解决方案所需的现代应用程序编程接口(API)。
另一项重要要求是遵守个人数据保护规定。塔吉克斯坦政府机构不得使用公开的外国云平台处理公民信息,所有数据都必须存储在国内。
因此,该项目需要自己的计算基础设施,能够在不向塔吉克斯坦境外传输信息的情况下运行人工智能。
NVIDIA H200 服务器位于达尔沃兹
新系统的计算能力由 darya.ai 提供,该公司在达尔沃兹拥有自己的数据中心。
继项目开发的前期阶段之后,所有必要的计算基础设施都直接位于塔吉克斯坦境内。
目前,人工智能模型的训练、查询处理和其他计算过程都在配备 NVIDIA H200 GPU 的 Supermicro 服务器上执行。
该作品使用了 NVIDIA CUDA 软件平台,该平台利用图形处理器加速计算。
该架构能够利用人工智能处理政府文件,同时满足国家数据存储和保护要求。
据英伟达称,这套新系统可在约 90 秒内生成许可证和执照申请结果。此外,人工智能驱动的决策还可以进行验证和审计。
塔吉克斯坦开发了自己的语言模型SoroLLM。
该项目的主要目标之一是创建能够完全理解塔吉克语的人工智能。
正如 NVIDIA 指出的那样,塔吉克语在用于训练现代语言模型的 Common Crawl 数据集中占比不到 0.01%。
这意味着塔吉克语在领先的人工智能系统的训练数据中严重缺乏代表性。
为了解决这个问题,zehnlab.ai 开发了 Soro 27B 国家大型语言模型,也称为 SoroLLM。
在创建过程中,专家们使用了开放规模模型,并额外使用专门准备的塔吉克语文本语料库对其进行了训练。
然后使用数万个塔吉克语示例对模型进行调整,使其能够适应各种指令和查询。
塔吉克斯坦第一个国家级大型语言模型于 2025 年 6 月发布,该国总统埃莫马利·拉赫蒙出席了发布会。
据开发者称,Soro 27B 在六项旨在评估塔吉克语人工智能质量的测试中,表现优于所有公开可用的同等规模的模型。
接下来,该团队正在考虑使用 NVIDIA NeMo 技术来进一步训练模型,并将计算任务分配到多个 NVIDIA H200 GPU 上。
一款用塔吉克语开发的人工智能安全系统已经问世。
与此同时,zehnlab.ai 的专家们开发了 Soro Guard 1B,这是第一个用于检查塔吉克语内容安全性的模型。
由于现有的现成解决方案不支持塔吉克语,开发人员不得不基于 NVIDIA 技术创建自己的系统。
该系统以NVIDIA Nemotron内容安全数据集和安全类别分类为基础,并针对塔吉克语和俄语进行了适配,其架构则参考了NemoGuard。
新模型旨在从安全角度检查用户请求和人工智能响应。
据开发者称,Soro Guard 1B 在检测塔吉克语、俄语和英语中的不安全内容时,其不安全 F1 分数超过 89%。
Ijozat AI 许可系统是如何运作的?
由 Epsilon3.ai 开发的 Ijozat AI 平台直接负责自动化许可流程。
它是由 Kubernetes 和 Docker 技术构建的软件服务复合体,并整合了多个专业人工智能代理。
每个代理在处理传入的应用程序时都会执行特定的任务。
在第一阶段,光学字符识别 (OCR) 系统从扫描的塔吉克语、俄语和英语文档中提取必要的信息。
然后,特工确定文件类型并选择处理顺序。
其他人员随后将身份和法律信息与政府登记册和数据库中的信息进行比对,以核实这些信息。
专职人员会分析潜在风险,并识别可疑或异常案例,以便由专家进行进一步审查。
国家语言模型 SoroLLM 在平台运行中发挥着核心作用。
她分析监管要求,回答申请人的问题,并根据文件审查结果生成结构化报告。
这样一来,政府官员就可以审查系统已经生成的报告,而无需独立审查大量的纸质文件。
在这种情况下,存在疑问的案件将被送交人工进一步核实。
应用程序处理时间已缩短至 90 秒
人工智能的应用显著加快了国家许可证办理系统的文档处理速度。
以前申请审核可能需要两到四周时间,而现在该平台可以在大约一分半钟内完成自动处理。
计算过程在塔吉克斯坦使用位于 darya.ai 数据中心的 NVIDIA 基础设施进行。
开发人员还在考虑如何进一步提高系统的性能。
具体而言,计划评估使用 NVIDIA TensorRT 技术来处理不断增加的 Soro 27B 语言模型请求的情况。
为了进一步培训和发展国家语言模型,正在考虑使用 NVIDIA NeMo。
这些技术解决方案有望增加同时处理的应用程序数量,并确保随着对数字政府服务需求的增长,平台能够持续扩展。